Skip to content

概率论·2 随机变量及其分布 ​

考纲内容 ​

  • 随机变量,随机变量分布函数的概念及其性质
  • 离散型随机变量的概率分布
  • 连续型随机变量的概率密度
  • 常见随机变量的分布
    • 离散型:0−1 分布、二项分布 B(n,p)、几何分布、超几何分布、泊松(Poisson)分布 P(λ)
    • 连续型:均匀分布 U(a,b) 、正态分布 N(μ,σ2)、指数分布,指数分布 E(λ)
  • 随机变量函数的分布

一、随机变量 ​

1. 随机变量 ​

考纲摘要:理解随机变量的概念,理解分布函数 F(x)=P{X≤x}(−∞<x<+∞) 的概念及性质,会计算与随机变量相联系的事件的概率

随机变量被定义为样本空间到实数集的映射,如下图所示:
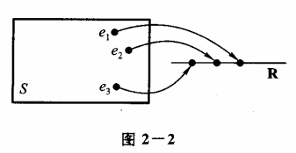
2

一个示例如下:

将一枚硬币抛掷三次,观察出现正面和反面的情况,样本空间是 S={HHH,HHT,HTH,THH,HTT,THT,TTH,TTT} 一个随机变量的定义如下:

X=X(e)={3,e=HHH,2,e=HHT,HTH,THH,1,e=HTT,THT,TTH,0,e=TTT

这里,X 的实际含义就是“H出现的次数”

2. 分布函数 ​

设 X 是一个随机变量,x 是任意实数,函数

F(x)=P{X≤x},x∈R

称为 X 的分布函数

由于 ∀x1,x2∈R,P{x1<X≤x2}=P{X≤x2}−P{X≤x1}=F(x2)−F(x1) 因此,如果已知 X 的分布函数,就可以知道它落在任意区间上的概率

分布函数 F(x) 的性质:

  • F(x) 是一个不减函数
  • 0≤F(x)≤1,且有 limx→−∞F(x)=0,limx→+∞F(x)=1
  • limΔx→0+F(x+Δx)=F(x),也就是说 F(x) 是右连续的

二、离散型随机变量及其分布率 ​

考纲摘要:

  1. 理解离散型随机变量及其概率分布的概念
  2. 掌握 0−1 分布、二项分布 B(n,p)、几何分布、超几何分布、泊松(Poisson)分布 P(λ) 及其应用

有些随机变量,它全部可能取到的值是有限个或可列无限多个,这种随机变量称为离散型随机变量

1. (0−1) 分布 ​

设随机变量 X 只可能取 0,1 两个值,其分布律为 P{X=k}=pk(1−p)1−k,也可以写成下表:

X01
pk1−pp

2. 伯努利试验与二项分布 B(n,p) ​

伯努利试验:设试验 E 只有两种可能的结果,分别记为事件 A 和其对立事件 A―。如果每次试验只有这两个结果中的一个出现,则称该试验为伯努利试验。

n 重伯努利试验:将试验 E 独立地重复进行 n 次,称这 n 次独立的伯努利试验为**n 重伯努利试验**。

以随机变量 X 表示在 n 重伯努利试验中事件 A 发生的次数,则 X 的概率分布为:

P{X=k}=Cnkpk(1−p)n−k,k=0,1,2,…,n

其中,p 是事件 A 发生的概率,1−p=q 是事件 A― 发生的概率,Cnk 是组合数,表示从 n 次试验中恰好选取 k 次事件 A 发生的方式数。

二项分布:随机变量 X 的分布称为参数为 n 和 p 的二项分布,记作 X∼B(n,p)。

二项分布也可以理解为 (p+q)n 的展开式中含 pkqn−k 项的系数,即二项式定理的应用。

数学期望:E(X)=np

方差:D(X)=np(1−p)

3. 几何分布 G(p) ​

在独立重复试验中,首次成功之前失败的次数

参数:单次成功的概率 p,X∼G(p) 的概率分布为:

P{X=k}=(1−p)kp

数学期望:E(X)=1p (若 X 表示首次成功所需的试验次数)方差:D(X)=1−pp2

注:若 X 表示首次成功前失败的次数,则 E(X)=1−pp。考研通常指前者(试验次数)。

4. 超几何分布 H(N,K,n) ​

N 个球中有 K 个白球,抽取 n 次,抽取结果中白球个数的分布

X∼H(N,K,n) 的概率分布为:

P{X=k}=CKkCN−Kn−kCNnE(X)=nKND(X)=nKN⋅N−KN⋅N−nN−1

5. 泊松分布 P(λ) ​

考纲摘要:了解泊松定理的结论和应用条件,会用泊松分布近似表示二项分布

设随机变量 X 的所有可能取值为 0,1,2,⋯,而各个值的概率为:

P{X=k}=λke−λk!,k=0,1,2,⋯

其中 λ>0 是常数,则称 X 服从参数为 λ 的泊松分布,记作 X∼P(λ)。

泊松分布的数学期望和方差为:

E(X)=λ,Var(X)=λ

泊松定理 ​

泊松定理是二项分布向泊松分布的渐近近似。当二项分布的试验次数 n 很大,且成功概率 p 很小时,二项分布可以用泊松分布近似。

设 n 是任意正整数,p 是一个随 n 变化的概率,满足 np=λ,其中 λ 为常数,则对于任一固定的非负整数 k,有:

limn→∞Cknpk(1−p)n−k=λke−λk!

这表示当 n 很大且 p 很小时,二项分布 B(n,p) 近似于泊松分布 P(λ=np)。

三、连续型随机变量 ​

考纲摘要:理解连续型随机变量及其概率密度的概念,掌握均匀分布 U(a,b) 、正态分布 N(μ,σ2)、指数分布及其应用,其中参数为 λ(λ>0) 的指数分布 E(λ) 的概率密度为

f(x)={λe−λx,x>00,x≤0

1. 概率密度 ​

如果对于随机变量 X 的分布函数 F(x),存在非负函数 f(x),使得:

∀x∈R,F(x)=∫−∞xf(t)dt

则称 X 为连续型随机变量,其中函数 f(x) 称为 X 的概率密度函数,它具有以下性质:

  • f(x)≥0
  • ∫−∞∞f(x)dx=1
  • ∀x1,x2∈R(x1≤x2),P{x1<x≤x2}=F(x2)−F(x1)=∫x1x2f(x)dx
  • 如果 f(x) 在点 x 处连续,则有 F′(x)=f(x)

2. 均匀分布 U(a,b) ​

如果随机变量 X 的概率密度为:

f(x)={1b−a,a<x<b0,others

则称 X 在区间 (a,b) 上服从均匀分布,记作 X∼U(a,b),显然,其分布函数如下所示:

F(x)={0,x<ax−ab−a,a≤x<b1,x≥b

其数学期望 E(X)=a+b2

3. 指数分布 E(λ) ​

如果随机变量 X 的概率密度为:

f(x)={λe−λx,x>00,x≤0

其中常数 λ>0,则称 X 是服从参数 λ 的指数分布,记作 X∼E(λ),显然,其分布函数如下所示:

F(x)={1−e−λx,x>00,x≤0

指数分布的性质具有无记忆性,即满足该等式:P{X>s+t|X>s}=P{X>t}

4. 正态分布 N(μ,σ2) ​

如果随机变量 X 的概率密度为:

f(x)=12πσexp⁡[−(x−μ)22σ2],−∞<x<∞

其中,μ,σ(σ>0) 为常数,则称 X 是服从参数 μ,σ 的正态分布(高斯分布),记作 X∼N(μ,σ2),其性质如下:

  • f(x) 的图像关于直线 x=μ 对称,也就是说:∀h>0,P{μ−h<X≤μ}=P{μ<X≤μ+h}
  • x=μ 是 f(x) 的最大值点,且 f(μ)=12πσ
  • f(x) 的图像在 x=μ+σ 处有拐点,曲线的渐近线是 x 轴,改变 μ 的值不会改变图像的形状,只会将其沿着 x 轴平移, μ 完全确定了曲线的位置,也称作位置参数

其分布函数为:

F(x)=12πσ∫−∞xexp⁡[−(t−μ)22σ2]dt

特别地,μ=0,σ=1 时,称作标准正态分布,其概率密度函数与分布函数分别表示成:

φ(x)=12πexp⁡[−x2/2]Φ(x)=12π∫−∞xexp⁡[−t2/2]dt性质:1.φ(x) 是偶函数,φ(−x)=φ(x)2.Φ(−x)=1−Φ(x)3.P{|X|≤a}=2Φ(a)−1

计算正态分布时,以下引理是有用的:若 X∼N(μ,σ2),则 X−μσ∼N(0,1),其分布函数:

F(x)=P{X≤x}={X−μσ≤x−μσ}=Φ(x−μσ)

这样一来,就可以通过标准正态分布的分布函数的函数值表来计算任意正态分布的分布函数值,根据此,还可以得到以下结论:

  • P{μ−σ<X<μ+σ}=Φ(1)−Φ(−1)≈68.26%
  • P{μ−2σ<X<μ+2σ}=Φ(2)−Φ(−2)≈95.44%
  • P{μ−3σ<X<μ+3σ}=Φ(3)−Φ(−3)≈99.74%

正态分布中随机变量落在 (μ−3σ,μ+3σ) 上几乎是肯定的是,这就是所谓3σ法则

四、随机变量函数的分布 ​

考纲摘要:会求随机变量函数的分布

1. 随机变量的函数的分布 ​

设有随机变量 X,Y,其中,Y=g(X),如果已知 X 的概率密度或分布函数,就可以求出 Y 的概率密度和分布函数

FY(y)=P{Y≤y}=P{g(X)≤y}

然后解不等式 g(X)≤y,设解出的区间为 D,而这个区间的界定显然与 y 有关,因此 FY(y)=P{X|X∈D},这样一来,就可以找到 FY(y) 使用 FX(y) 来表示的式子,进而求出 FY(y)。例如:

χ2 分布 ​

设 X∼N(0,1),求 Y=X2 的概率密度:

FY(y)=F{Y≤y}=F{X2≤y}=F{−y≤X≤y}=FX(y)−FX(−y)fY(y)=FY′(y)=fX(y)+fX(−y)2y=12πe−y/2+12πe−y/22y=12πy−1/2e−y/2

Y 落在 (−∞,0] 上是不可能的,因此 Y 的概率密度函数为:

fY(y)={12πy−1/2e−y/2,y>00,y≤0

这个 Y 也称为服从自由度为 1 的 χ2 分布

定理:设随机变量 X 具有概率密度 fX(x),−∞<x<∞,又设函数 g(x) 处处可导且 g′(x)>0 (或恒有 g′(x)<0),则 Y=g(X) 是连续型随机变量,其概率密度为:

fY(y)={fX[h(y)]|h′(y)|,α<y<β0,others

其中,α=min{g(−∞),g(∞)},β=max{g(−∞),g(∞)},h(y)=g−1(y)


常见分布速查表 ​

分布记号E(X)D(X)
0-1 分布B(1,p)pp(1-p)
二项分布B(n,p)npnp(1-p)
泊松分布P(λ)λλ
几何分布G(p)1/p(1−p)/p2
均匀分布U(a,b)(a+b)/2(b−a)2/12
指数分布E(λ)1/λ1/λ2
正态分布N(μ,σ2)μσ2
卡方分布χ2(n)n2n
t 分布t(n)0n/(n-2)

易错辨析 ​

易错表述正确理解
"P(A)=0 则 A 不可能发生"❌ 连续型中 P(X=a)=0 但 a 可能取到
"不相关等于独立"❌ 仅二维正态时不相关 ⇔ 独立
"E(XY)=E(X)E(Y) 总成立"❌ 仅在独立时成立(不相关仅对线性无关)

Released under the MIT License.