Skip to content

数理统计·1 数理统计的基本概念 ​

考纲内容 ​

  • 总体、个体、简单随机样本、统计量、样本均值、样本方差、样本矩
  • χ2 分布,t 分布,F 分布,分位数,正态总体的常用抽样分布

本章脉络 ​

由简单随机样本出发,构造不含未知参数的函数,即得到统计量:

  • 常用统计量:样本平均值、样本方差、样本标准差、样本 k 阶原点矩、样本 k 阶中心矩
  • 经验分布函数:Fn(x),当 n→∞ 时依概率一致收敛于总体分布函数
  • 三大抽样分布:χ2 分布、t 分布、F 分布
  • 正态总体的统计量性质:把上面三者与 X―,S2 联系起来,是后续参数估计与假设检验的基础
χ2(n)→ 标准正态平方和 t(n)=XY/n→ 两个卡方之比 F(n1,n2)

一、随机样本 ​

1. 随机样本诸概念的定义 ​

在数理统计中,我们通常研究某个对象的特定数量指标。例如,研究某种型号灯泡的寿命。为此,我们会进行与这一数量指标相关的随机试验。这些试验的结果值不一定都相同,且其数量也不一定是有限的。

  • 每一个可能的观察值称为个体。
  • 总体中包含的所有个体的总数称为总体的容量。

根据容量的大小,可以将总体分为:

  • 有限总体:容量有限的总体。
  • 无限总体:容量无限的总体。

设 X 是具有分布函数 F 的随机变量。若 X1,X2,⋯,Xn 是具有相同分布函数 F 的、相互独立的随机变量则称 X1,X2,⋯,Xn 为从分布函数 F(或总体 F,或总体 X)得到的容量为 n 的简单随机样本,简称 样本 它们的观察值 x1,x2,⋯,xn 称为 样本值,又称为 X 的 n 个独立的观察值。

2. 分位数 ​

定义设有容量为 n 的样本观察值 x1,x2,⋯,xn,样本 p 分位数 (0<p<1) 记为 xp,它具有以下的性质:

  1. 至少有 np 个观察值小于或等于 xp
  2. 至少有 n(1-p) 个观察值大于或等于 xp

显然,p=12 时,就是我们熟悉的中位数

样本 p 分位数可按以下法则求得:

首先,将 x1,x2,⋯,xn 按自小到大的次序排列成 x(1)≤x(2)≤⋯≤x(n)。

  1. 若 np 不是整数,则只有一个数据满足定义中的两点要求,这一数据位于大于 np 的最小整数处,即为位于 [np]+1 处的数。例如,n=12,p=0.9,则 np=10.8,n(1−p)=1.2。则 xp 的位置应满足至少有 10.8 个数据 ≤xp(xp 应位于第 11 或大于第 11 处);且至少有 1.2 个数据 ≥xp(xp 应位于第 11 或小于第 11 处),故 xp 应位于第 11 处。

  2. 若 np 是整数。例如在 n=20,p=0.95 时,xp 的位置应满足至少有 19 个数据 ≤xp(xp 应位于第 19 或大于第 19 处)且至少有 1 个数据 ≥xp(xp 应位于第 19 或小于第 19 处)。此时,取第 19 和第 20 这两个数据的平均值作为 xp

综上,

xp={x([np]+1),当 np 不是整数12[x(np)+x(np+1)],当 np 是整数

特别,当 p=0.5 时,0.5 分位数 x0.5 也记为 Q2 或 M,称为样本中位数,即有

x0.5={x[n2]+1,当 n 是奇数12[x(n2)+x(n2+1)],当 n 是偶数

易知,当 n 是奇数时,中位数 x0.5 就是 x(1)≤x(2)≤⋯≤x(n) 这一数组最中间的一个数;而当 n 是偶数时,中位数 x0.5 就是 x(1)≤x(2)≤⋯≤x(n) 这一数组中最中间两个数的平均值。

0.25 分位数 x0.25 称为第一四分位数,又记为 Q1;0.75 分位数 x0.75 称为第三四分位数,又记为 Q3。 x0.25,x0.5,x0.75 在统计中是很有用的

二、抽样分布 ​

1. 统计量 ​

1. 统计量的定义 ​

定义:设 X1,X2,⋯,Xn 是来自总体 X 的一个样本,g(X1,X2,⋯,Xn) 是 X1,X2,⋯,Xn 的函数,若 g 中不含未知参数,则称 g(X1,X2,⋯,Xn) 是一统计量。因为 X1,X2,⋯,Xn 都是随机变量,而统计量 g(X1,X2,⋯,Xn) 是随机变量的函数,因此统计量是一个随机变量。设 x1,x2,⋯,xn 是相应于样本 X1,X2,⋯,Xn 的样本值,则称 g(x1,x2,⋯,xn) 是 g(X1,X2,⋯,Xn) 的观察值。

2. 常用的统计量及其观察值 ​

下面列出几个常用的统计量及其观察值。设 X1,X2,⋯,Xn 是来自总体 X 的一个样本,x1,x2,⋯,xn 是这一样本的观察值。

样本平均值

X―=1n∑i=1nXi,x―=1n∑i=1nxi

样本方差

S2=1n−1∑i=1n(Xi−X―)2=1n−1(∑i=1nXi2−nX―2)S2=1n−1∑i=1n(xi−x―)2=1n−1(∑i=1nxi2−nx―2)

样本标准差

S=S2=1n−1∑i=1n(Xi−X―)2S=S2=1n−1∑i=1n(xi−x―)2

样本 k 阶(原点)矩

Ak=1n∑i=1nXik,k=1,2,⋯Ak=1n∑i=1nxik,k=1,2,⋯

样本 k 阶中心矩

Bk=1n∑i=1n(Xi−X―)k,k=2,3,⋯Bk=1n∑i=1n(xi−x―)k,k=2,3,⋯

3. 经验分布函数 ​

我们还可以作出与总体分布函数 F(x) 相应的统计量——经验分布函数。它的作法如下:

设 X1,X2,…,Xn 是总体 F 的一个样本,用 S(x) 表示 X1,X2,…,Xn 中不大于 x 的随机变量的个数。定义经验分布函数 Fn(x) 为:

Fn(x)=1nS(x),−∞<x<∞

对于一个样本值,经验分布函数 Fn(x) 的观察值是很容易得到的(Fn(x) 的观察值仍以 Fn(x) 表示)。例如:

  1. 设总体 F 具有一个样本值 1,2,3,则经验分布函数 F3(x) 的观察值为:
F3(x)={0,若 x<1,13,若 1≤x<2,23,若 2≤x<3,1,若 x≥3
  1. 设总体 F 具有一个样本值 1,2,2,则经验分布函数 F3(x) 的观察值为:
F3(x)={0,若 x<1,13,若 1≤x<2,1,若 x≥2

一般,设 x1,x2,…,xn 是总体 F 的一个容量为 n 的样本值。先将 x1,x2,…,xn 按自小到大的次序排列,并重新编号,设为 x(1)≤x(2)≤⋯≤x(n)。则经验分布函数 Fn(x) 的观察值为:

Fn(x)={0,若 x<x(1),kn,若 x(k)≤x<x(k+1),1,若 x≥x(n)

对于经验分布函数 Fn(x),格里汶科(Glivenko)在1933年证明了以下的结果:对于任一实数 x,当 n→∞ 时,Fn(x) 以概率1一致收敛于分布函数 F(x) ,即

P(limn→∞sup|Fn(x)−F(x)|=0)=1

因此,对于任一实数 x,当 n 充分大时,经验分布函数的任一个观察值 Fn(x) 与总体分布函数 F (x) 只有微小的差别,从而在实际上可当作 F(x) 来使用。

这里的 sup 是“上确界”(supremum)的缩写。在数学中,给定一个集合 S,该集合的上确界是所有上界中最小的一个。换句话说,supS 是 S 的最小上界。

在这种情况下,sup|Fn(x)−F(x)| 表示在所有 x 上,|Fn(x)−F(x)| 的最大值。这个值用于描述 Fn(x) 和 F(x) 之间的最大差异。因此,整个表达式 limn→∞sup|Fn(x)−F(x)|=0 意味着当样本量 n 趋于无穷大时,经验分布函数 Fn(x) 与总体分布函数 F(x) 的最大差异趋于零。

2. 常用的抽样分布统计量 ​

考纲摘要:了解 χ2 分布、t 分布和 F 分布的概念及性质,了解上侧 a 分位数的概念并会查表计算

1. χ2 分布 ​

设 X1,X2,⋯,Xn 是来自总体 N(0,1) 的样本,则称统计量

χ2=X12+X22+⋯+Xn2

为服从自由度为 n 的 χ2 分布,记作 χ2∼χ2(n)

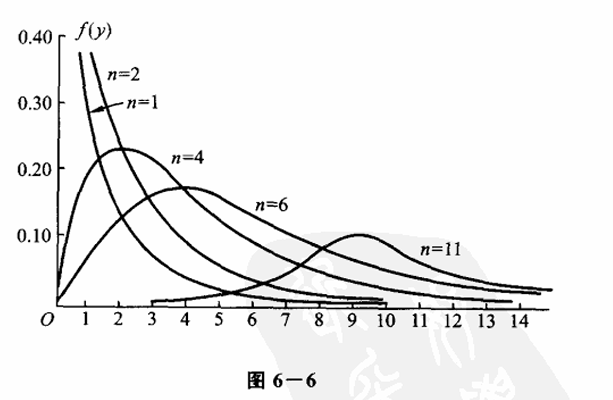
χ2(n) 分布的概率密度为

f(y)={12n/2Γ(n/2)yn/2−1e−y/2,y>00,y≤0

其图像如下所示:

4

χ2 分布的可加性:设 χ12∼χ2(n1),χ22∼χ2(n2),且 χ12,χ22 相互独立,则有 χ12+χ22∼χ2(n1+n2)

χ2 分布的数学期望和方差:对于 χ2∼χ2(n),E(χ2)=n,D(χ2)=2n

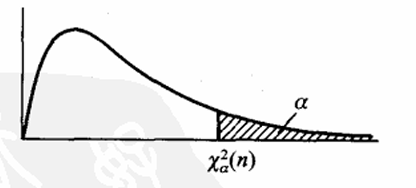
χ2 分布的分位点:对于给定的 0<α<1,称满足条件

P{χ2>χα2(n)}=∫χα2(n)∞f(y)dy=α

的点 χα2(n) 为 χ2(n) 上的 α 分位点,求法如下:

  • n 在 40 及以下时,查表
  • n 充分大时,近似的有 χα2(n)≈12(zα+2n−1)2,在 n>40 时可采用该近似式

5

χα2(n) 应该是一个与 α,n 有关的常数

2. t 分布 ​

设 X∼N(0,1),Y∼χ2(n),且 X,Y 相互独立,则称随机变量

t=XY/n

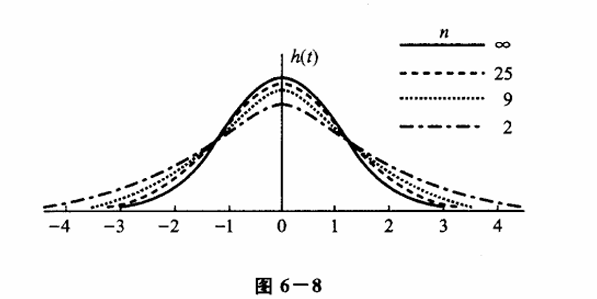
为服从自由度为 n 的 t 分布,记作 t∼t(n),它也称作学生氏分布,其概率密度函数为:

h(t)=Γ[(n+1)/2]πnΓ(n/2)(1+t2n)−(n+1)/2,t∈R

其图像如下所示:

6

t 分布概率密度函数的图像是关于 t=0 轴对称的。此外,由于

limn→∞h(t)=12πe−t2/2

也就是说,当 n 足够大时,t 分布的近似于 N(0,1) 分布

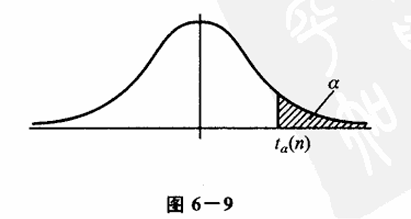
t 分布的分位点:对于给定的 0<α<1,称满足条件

P{t>tα(n)}=∫tα(n)∞h(t)dt=α

的点 tα(n) 为 t(n) 分布上的 α 分位点由于 t 分布图像的对称性,可知 t1−α(n)=−tα(n)。该分布的分位点也可以通过查表来求解

7

3. F 分布 ​

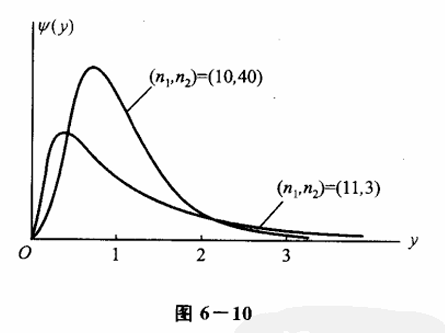
设 U∼χ2(n1),V∼χ2(n2) 且相互独立,则称随机变量 F=U/n1V/n2 为服从自由度为 (n1,n2) 的 F 分布,记作 F∼F(n1,n2),由定义知:1F∼F(n2,n1)

其概率密度为:

ψ(y)={Γ[(n1+n2)/2](n1/n2)n1/2y(n1/2)−1Γ(n1/2)Γ(n2/2)[1+(n1y/n2)](n1+n2)/2,y>00,y≤0

其图像如下:

8

F 分布的分位点,对于给定的 0<α<1,称满足条件

P{F>Fa(n1,n2)}=∫Fa(n1,n2)∞ψ(y)dy=α

的点 Fa(n1,n2) 为 F(n1,n2) 分布上的 α 分位点,求法亦是查表。它有以下性质:

F1−α(n1,n2)=1Fα(n2,n1)

4. 正态总体的样本均值与样本方差的分布 ​

考纲摘要:了解正态总体的常用抽样分布

设总体 X (无论其服从什么分布,只要存在数学期望和方差)的数学期望为 μ,方差为 σ2,X1,X2,⋯,Xn 是来自 X 的一个样本,X―,S2 分别是样本均值和样本方差,则有:

E(X―)=μ,D(X―)=σ2n,E(S2)=σ2

当 X∼N(μ,σ2) 时存在以下定理:

1. 定理一 ​

设 X1,X2,…,Xn 是来自正态总体 N(μ,σ2) 的样本,样本均值为 X―,则有

X―∼N(μ,σ2n)
2. 定理二 ​

设 X1,X2,…,Xn 是来自总体 N(μ,σ2) 的样本,X― 和 S2 分别是样本均值和样本方差,则有

(n−1)S2σ2∼χ2(n−1)

并且 X― 与 S2 相互独立。

3. 定理三 ​

设 X1,X2,…,Xn 是来自总体 N(μ,σ2) 的样本,X― 和 S2 分别是样本均值和样本方差,则有

X―−μS/n∼t(n−1)
4. 定理四 ​

设 X1,X2,…,Xn1 和 Y1,Y2,…,Yn2 分别是来自正态总体 N(μ1,σ12) 和 N(μ2,σ22) 的样本,且这两个样本相互独立。设

X―=1n1∑i=1n1Xi,Y―=1n2∑i=1n2Yi

分别是这两个样本的样本均值;并且

S12=1n1−1∑i=1n1(Xi−X―)2,S22=1n2−1∑i=1n2(Yi−Y―)2

分别是这两个样本的样本方差,则有

S12S22∼F(n1−1,n2−1)

当 σ12=σ22=σ2 时,有

(X―−Y―)−(μ1−μ2)Sw1n1+1n2∼t(n1+n2−2)

其中

Sw2=(n1−1)S12+(n2−1)S22n1+n2−2,Sw=Sw2

Released under the MIT License.